{"cells":[{"metadata":{"_uuid":"d629ff2d2480ee46fbb7e2d37f6b5fab8052498a","_cell_guid":"79c7e3d0-c299-4dcb-8224-4455121ee9b0","trusted":true},"cell_type":"markdown","source":"## Descrição dos dados utilizados\n\n\n\nNeste *notebook* foram utilizados dois conjuntos de dados para avaliar os algoritmos de classificação e agrupamento. A base de dados utilizada nos métodos supervisionados foi retirada do site [UCI](https://archive.ics.uci.edu/ml/datasets/Forest+type+mapping#), tais dados foram usados no artigo publicado por [Johnson et al., (2012)](https://www.tandfonline.com/doi/full/10.1080/01431161.2011.629637?scroll=top&needAccess=true), denominado \"*Using geographically weighted variables for image classification*\", no qual utilizou-se os índices espectrais para classificar dois tipos de árvores, *Cryptomeria japonica* (Sugi) e *Chamaecyparis obtusa* (Hinoki), e um tipo de floresta. A área de estudo apresentada na Figura 1 compreende a área florestal da prefeitura de Ibaraki do Japão. \n\n#### Área de estudo\n\n\n \n Figura 1: Localização da área de estudo\n\n\n
\nAs imagens apresentadas acima foram imageadas pelo sensor ASTER a bordo do satélite Terra, nos períodos de Setembro de 2010, Março de 2011 e Maio de 2011, respectivamente. \n\n`Observação`: Os exemplos apresentados neste documento são feitos utilizando as bibliotecas [scikit-learn](https://scikit-learn.org/stable/), [keras](https://keras.io/) e [Somoclu](https://github.com/peterwittek/somoclu)\n\n## Métricas de avaliação dos modelos\n\n- Índice Kappa: Utilizado para medir o grau de concordância entre amostras.\n- Score: Porcentagem de elementos classificados corretamente.\n\n## Aprendizado supervisionado\n\nEsta seção apresenta exemplos de técnicas de aprendizado de máquina supervisionados. Para os exemplos foi feita a utilização dos dados gerados no artigo [Using geographically weighted variables for image classification](https://www.tandfonline.com/doi/full/10.1080/01431161.2011.629637).","execution_count":null},{"metadata":{"trusted":true},"cell_type":"code","source":"# !conda install scikit-learn=0.22.1 -y","execution_count":null,"outputs":[]},{"metadata":{"_kg_hide-output":false,"trusted":true},"cell_type":"code","source":"# !conda install -c conda-forge somoclu -y","execution_count":null,"outputs":[]},{"metadata":{"trusted":true},"cell_type":"code","source":"import numpy as np\nimport matplotlib.pyplot as plt\n# plt.style.use('ggplot')\n\ndef plot_dt(tree, feature_names, class_names):\n \"\"\"Função criada para a visualização da árvore de decisão gerada \n \"\"\"\n from sklearn.tree import plot_tree\n \n fig, ax = plt.subplots(1, 1, figsize=(10, 10))\n plot_tree(tree, ax = ax, feature_names=feature_names, class_names=class_names)\n\ndef plot_dendrogram(model, **kwargs):\n \"\"\"Função para a geração de um dendograma de um modelo sklearn.cluster.AgglomerativeClustering\n \n See:\n Função retirada da documentação oficial do scikit-learn\n \"\"\"\n from scipy.cluster.hierarchy import dendrogram\n \n plt.title('Agrupamento hierárquico')\n \n counts = np.zeros(model.children_.shape[0])\n n_samples = len(model.labels_)\n for i, merge in enumerate(model.children_):\n current_count = 0\n for child_idx in merge:\n if child_idx < n_samples:\n current_count += 1 # leaf node\n else:\n current_count += counts[child_idx - n_samples]\n counts[i] = current_count\n\n linkage_matrix = np.column_stack([model.children_, model.distances_,\n counts]).astype(float)\n\n # Plot the corresponding dendrogram\n dendrogram(linkage_matrix, **kwargs)\n plt.xlabel(\"Índice dos dados (Em parenteses representam a quantidade de elementos no grupo).\")\n plt.show()\n \n\ndef plot_cm(cm_sklearn, labels):\n \"\"\"Função para gerar matriz de confusão\n \"\"\"\n \n import seaborn as sn\n \n df_cm = pd.DataFrame(cm_sklearn, index = [i for i in labels], columns = [i for i in labels])\n plt.figure(figsize = (10,7))\n sn.heatmap(df_cm, annot=True)\n \n# Configuração das classes\nfrom sklearn import preprocessing\n\nle = preprocessing.LabelEncoder()\n_ = le.fit([\"d\", \"h\", \"o\", \"s\"])","execution_count":null,"outputs":[]},{"metadata":{"trusted":true},"cell_type":"code","source":"# importando a função para calcular a matriz de confusão\nfrom sklearn.metrics import confusion_matrix","execution_count":null,"outputs":[]},{"metadata":{"trusted":true},"cell_type":"code","source":"import numpy as np\nimport pandas as pd","execution_count":null,"outputs":[]},{"metadata":{},"cell_type":"markdown","source":"Definindo as variáveis para o armazenamento dos dados de tipos de florestas.","execution_count":null},{"metadata":{"trusted":true},"cell_type":"code","source":"train_data = pd.read_csv('https://raw.githubusercontent.com/dataAt/ml-aplicado-dados-espacial/master/src/metodos-supervisionados/dados/forest_type/training.csv')\ntest_data = pd.read_csv('https://raw.githubusercontent.com/dataAt/ml-aplicado-dados-espacial/master/src/metodos-supervisionados/dados/forest_type/testing.csv')","execution_count":null,"outputs":[]},{"metadata":{},"cell_type":"markdown","source":"O processo de treinamento de um algoritmo supervisionado, exige a existência de amostras já rotuladas sobre os dados, ou seja, para cada conjunto de entrada que será mapeado pelo algoritmo já deve existir uma resposta.\n\nAlém disto, para a validação da generalização do algoritmo, é necessário um conjunto de dados que ainda não tenha sido apresentado para o algoritmo, para que então, a generalização de seu conhecimento seja assegurada. Este conjunto de dados foi dividido em dados de `treino` e `teste` previamente, pelo criador dos dados.\n\nAbaixo, o conjunto de dados carregado é separado em valores de `x`, que representam as entradas para o algoritmo, e valores `y`, que representam os valores desejados que são esperados do algoritmo retornar.","execution_count":null},{"metadata":{"trusted":true},"cell_type":"code","source":"data_columns = ['b1', 'b2', 'b3', 'b4', 'b5', 'b6', 'b7', 'b8', 'b9']","execution_count":null,"outputs":[]},{"metadata":{"trusted":true},"cell_type":"code","source":"x_train = train_data[data_columns]\ny_train = train_data['class']","execution_count":null,"outputs":[]},{"metadata":{"trusted":true},"cell_type":"code","source":"x_test = test_data[data_columns]\ny_test = test_data['class']","execution_count":null,"outputs":[]},{"metadata":{"trusted":true},"cell_type":"code","source":"## Definindo classes presentes no conjunto de dados\nclass_names = y_train.unique().tolist()\nclass_names","execution_count":null,"outputs":[]},{"metadata":{},"cell_type":"markdown","source":"### K-Nearest Neighbors (KNN)\n\n\nEsta seção apresenta a utilização do algoritmo `K-Nearest Neighbors (KNN)` através da biblioteca de *machine learning* scikit-learn\n\nPara iniciar, todos os pacotes necessários para a utilização do algoritmo são importados.","execution_count":null},{"metadata":{"trusted":true},"cell_type":"code","source":"import numpy as np\nimport pandas as pd\nfrom plotnine import *\nfrom sklearn.neighbors import KNeighborsClassifier\nfrom sklearn.metrics import confusion_matrix, cohen_kappa_score, accuracy_score","execution_count":null,"outputs":[]},{"metadata":{},"cell_type":"markdown","source":"No `scikit-learn` o algoritmo KNN é oferecido através da classe `sklearn.neighbors.KNeighborsClassifier`. Para começar sua utilização, basta fazer a `instância` e treinar o modelo.\n\nFaça inicialmente a instância da classe do KNN.","execution_count":null},{"metadata":{"trusted":true},"cell_type":"code","source":"knn = KNeighborsClassifier()","execution_count":null,"outputs":[]},{"metadata":{},"cell_type":"markdown","source":"Com a instância feita, é necessário utilizar o método `fit` para que o algoritmo seja treinado.","execution_count":null},{"metadata":{"trusted":true},"cell_type":"code","source":"knn.fit(x_train, y_train)","execution_count":null,"outputs":[]},{"metadata":{},"cell_type":"markdown","source":"Já temos o algoritmo knn treinado e pronto para realizar a classificação de outros dados. Para testar, utilizamos o método `predict` paras os dados de testes, que como citado, foram previamente separados.","execution_count":null},{"metadata":{"trusted":true},"cell_type":"code","source":"y_pred = knn.predict(x_test)","execution_count":null,"outputs":[]},{"metadata":{},"cell_type":"markdown","source":"Utilizar as métricas para avaliar a qualidade dos resultados apresentados pelo algoritmo.","execution_count":null},{"metadata":{"trusted":true},"cell_type":"code","source":"# Calculando o índice Kappa\ncohen_kappa_score(y_pred, y_test)","execution_count":null,"outputs":[]},{"metadata":{"trusted":true},"cell_type":"code","source":"# Calculando o Score\naccuracy_score(y_pred, y_test)","execution_count":null,"outputs":[]},{"metadata":{},"cell_type":"markdown","source":"Este algoritmo necessita da definição de um valor de `K`, mas a utilização acima não possui tal definição.\n\nCaso o valor de `K` não seja especificado, utiliza-se o valor de `K` igual a 5. Porém, não há certeza de que este é o melhor valor de `K` para nosso conjunto de dados.\n\nA definição deste valor pode não ser algo fácil, há bibliografias por exemplo, que recomendam que o valor de `K` sejam iguais a sqrt(n), onde n é a quantidade de amostras nos dados.\n\nNo nosso caso, vamos fazer vários testes para buscar o melhor valor de `K`. Cada teste consiste no treinamento do algoritmo com o valor de `K` diferente, sendo que este vária de 1 à 30.","execution_count":null},{"metadata":{"trusted":true},"cell_type":"code","source":"resultados = {'Kappa': [], 'k': [], 'Score': []}\nfor k_value in range(1, 15):\n resultados['k'].append(k_value)\n \n neigh = KNeighborsClassifier(n_neighbors=k_value)\n neigh.fit(x_train, y_train)\n \n y_pred = neigh.predict(x_test)\n \n resultados['Kappa'].append(cohen_kappa_score(y_pred, y_test))\n resultados['Score'].append(accuracy_score(y_pred, y_test))\n\nresultados = pd.DataFrame(resultados)\n\n# Visualizando os resultados\nresultados.head()","execution_count":null,"outputs":[]},{"metadata":{"trusted":true},"cell_type":"code","source":"# Transformando os dados em long para facilitar o plot\nresultados = resultados.melt('k', var_name = 'Medidas')","execution_count":null,"outputs":[]},{"metadata":{"trusted":true},"cell_type":"code","source":"(\n ggplot(resultados, aes(x = 'k', y = 'value', color = 'Medidas'))\n + geom_line()\n + theme_bw()\n + facet_grid('~Medidas', space = 'free_y', scales = 'free')\n + scale_x_continuous(breaks = np.arange(1, 17))\n + labs(\n title = 'Métricas de avaliação - KNN',\n x = 'Quantidade de vizinhos (K)',\n y = 'Acurácia'\n )\n)","execution_count":null,"outputs":[]},{"metadata":{},"cell_type":"markdown","source":"No plot gerado, foi possível perceber que a quantidade de elementos que nos traz os melhores resultados de predição é 2, desta forma podemos fazer a aplicação do método KNN utilizando `k` igual a 2.","execution_count":null},{"metadata":{"trusted":true},"cell_type":"code","source":"knn = KNeighborsClassifier(n_neighbors=2)\nknn.fit(x_train, y_train)\ny_pred = knn.predict(x_test)","execution_count":null,"outputs":[]},{"metadata":{"trusted":true},"cell_type":"code","source":"# Calculando o índice Kappa\ncohen_kappa_score(y_pred, y_test)","execution_count":null,"outputs":[]},{"metadata":{"trusted":true},"cell_type":"code","source":"# Calculando o Score\naccuracy_score(y_pred, y_test)","execution_count":null,"outputs":[]},{"metadata":{"trusted":true},"cell_type":"code","source":"# Resultados do KNN\ny_pred = knn.predict(x_test)\nknn_cm = confusion_matrix(y_test, y_pred)\nplot_cm(knn_cm, \"dhos\")","execution_count":null,"outputs":[]},{"metadata":{},"cell_type":"markdown","source":"### Árvore de decisão\n\n\nEsta seção apresenta a utilização do algoritmo `Árvore de decisão` através da biblioteca de *machine learning* scikit-learn\n\nPara iniciar, todos os pacotes necessários para a utilização do algoritmo são importados.","execution_count":null},{"metadata":{"trusted":true},"cell_type":"code","source":"from sklearn.tree import DecisionTreeClassifier","execution_count":null,"outputs":[]},{"metadata":{},"cell_type":"markdown","source":"No `scikit-learn` o algoritmo de árvore de decisão é oferecido através da classe `sklearn.tree.DecisionTreeClassifier`.\nBasta definir `instância` e treinar o modelo.","execution_count":null},{"metadata":{"trusted":true},"cell_type":"code","source":"clf = DecisionTreeClassifier()","execution_count":null,"outputs":[]},{"metadata":{},"cell_type":"markdown","source":"Para realizar o treinamento basta utilizamos o método `fit`, como feito no `KNN`.","execution_count":null},{"metadata":{"trusted":true},"cell_type":"code","source":"clf = clf.fit(x_train, y_train)","execution_count":null,"outputs":[]},{"metadata":{},"cell_type":"markdown","source":"Com a árvore treinada, façamos a geração das métricas de avaliação do modelo.","execution_count":null},{"metadata":{"trusted":true},"cell_type":"code","source":"y_pred = clf.predict(x_test)","execution_count":null,"outputs":[]},{"metadata":{"trusted":true},"cell_type":"code","source":"# Calculando o índice Kappa\ncohen_kappa_score(y_pred, y_test)","execution_count":null,"outputs":[]},{"metadata":{"trusted":true},"cell_type":"code","source":"# Calculando o Score\naccuracy_score(y_test, y_pred)","execution_count":null,"outputs":[]},{"metadata":{},"cell_type":"markdown","source":"Os resultados não foram ruins, o que é interessante.","execution_count":null},{"metadata":{"trusted":true},"cell_type":"code","source":"plot_dt(clf, data_columns, class_names)","execution_count":null,"outputs":[]},{"metadata":{},"cell_type":"markdown","source":"**Problema**: a árvore gerada está muito complexa, tem muitas decisões sendo tomadas.\n\n**Causa**: sinal de **overfitting**, onde a árvore de decisão não grava características gerais dos dados, mas sim, as características especificas dos dados.\n\n**Solução**: realizar um `corte` na árvore e limitar sua profundidade a 2.","execution_count":null},{"metadata":{"trusted":true},"cell_type":"code","source":"# Com a árvore cortada, façamos todo o processo de avaliação e visualização de dados.\nclf = DecisionTreeClassifier(max_depth=2)\nclf = clf.fit(x_train, y_train)\ny_pred = clf.predict(x_test)","execution_count":null,"outputs":[]},{"metadata":{"trusted":true},"cell_type":"code","source":"# Calculando o índice Kappa\ncohen_kappa_score(y_pred, y_test)","execution_count":null,"outputs":[]},{"metadata":{"trusted":true},"cell_type":"code","source":"# Calculando o Score\naccuracy_score(y_test, y_pred)","execution_count":null,"outputs":[]},{"metadata":{"trusted":true},"cell_type":"code","source":"plot_dt(clf, data_columns, class_names)","execution_count":null,"outputs":[]},{"metadata":{"trusted":true},"cell_type":"code","source":"# Resultados da árvore de decisão\ny_pred = clf.predict(x_test)\nclf_cm = confusion_matrix(y_test, y_pred)\nplot_cm(clf_cm, \"dhos\")","execution_count":null,"outputs":[]},{"metadata":{},"cell_type":"markdown","source":"### Redes Neurais Artificiais (RNA)\n\n\nEsta seção apresenta a utilização de `Redes Neurais Artificiais` através da biblioteca de `Deep Learning` Keras.\n\nPara iniciar, todos os pacotes necessários para a utilização do algoritmo são importados.","execution_count":null},{"metadata":{},"cell_type":"markdown","source":"O modelo de rede neural criado possui 4 camadas, sendo elas:\n - 1° Camada: Entrada dos dados;\n - 2° Camada: Camada oculta;\n - 3° Camada: Camada oculta;\n - 4° Camada: Camada de saída (Classificação).\n \nO modelo gerado é igual ao exibido na Figura abaixo, retiradas das [notas de aula - CS231n](http://cs231n.github.io/convolutional-networks/)","execution_count":null},{"metadata":{},"cell_type":"markdown","source":"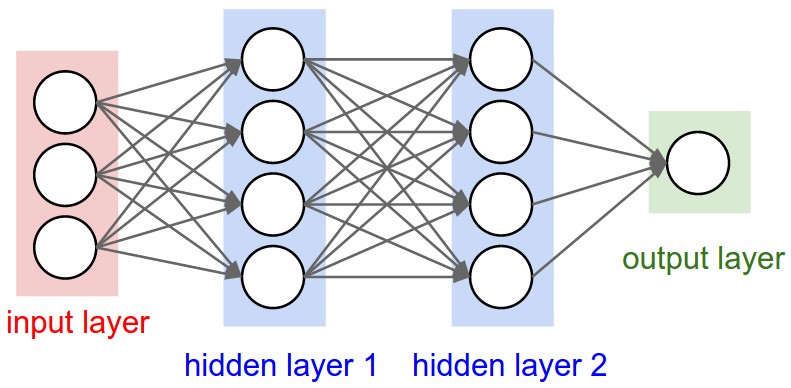","execution_count":null},{"metadata":{"trusted":true},"cell_type":"code","source":"from keras.layers import Dense\nfrom keras.models import Sequential\nfrom sklearn.preprocessing import OneHotEncoder, StandardScaler","execution_count":null,"outputs":[]},{"metadata":{},"cell_type":"markdown","source":"Com os pacotes carregados, inicialmente faça a conversão dos dados categóricos que estão presentes no conjunto de dados. Tal conversão é necessária para que os modelos de rede neural gerados pelo `Keras` consigam entender que os dados possuem o tipo categórico.","execution_count":null},{"metadata":{"trusted":true},"cell_type":"code","source":"enc = OneHotEncoder()\n\ny_train_factor = enc.fit_transform(train_data['class'].values[:, np.newaxis]).toarray()\ny_test_factor = enc.fit_transform(test_data['class'].values[:, np.newaxis]).toarray()","execution_count":null,"outputs":[]},{"metadata":{},"cell_type":"markdown","source":"Agora, vamos recuperar algumas informações do conjunto de dados, sendo elas, a quantidade de atributos e classes presentes nos dados.","execution_count":null},{"metadata":{"trusted":true},"cell_type":"code","source":"n_features = x_train.shape[1]\nn_classes = y_train_factor.shape[1]","execution_count":null,"outputs":[]},{"metadata":{"trusted":true},"cell_type":"code","source":"model = Sequential(name='Modelo1')\nmodel.add(Dense(4, input_dim=n_features, activation='relu'))\nmodel.add(Dense(10,activation='relu'))\nmodel.add(Dense(20, activation='relu'))\nmodel.add(Dense(n_classes, activation='softmax'))","execution_count":null,"outputs":[]},{"metadata":{},"cell_type":"markdown","source":"Após a construção do modelo, vamos fazer sua `materialização` através do método `compile`.","execution_count":null},{"metadata":{"trusted":true},"cell_type":"code","source":"model.compile(loss='categorical_crossentropy', \n optimizer='adam', \n metrics=['accuracy'])","execution_count":null,"outputs":[]},{"metadata":{},"cell_type":"markdown","source":"Vejamos o resumo do modelo que foi gerado","execution_count":null},{"metadata":{"trusted":true},"cell_type":"code","source":"model.summary()","execution_count":null,"outputs":[]},{"metadata":{},"cell_type":"markdown","source":"Certo, o modelo está pronto para ser treinado, façamos isto com o método `fit`.","execution_count":null},{"metadata":{"trusted":true},"cell_type":"code","source":"history = model.fit(x_train, y_train_factor,\n batch_size=5,\n epochs=85,\n verbose=1,\n validation_data=(x_test, y_test_factor),)","execution_count":null,"outputs":[]},{"metadata":{},"cell_type":"markdown","source":"Tendo o modelo treinado, façamos a avaliação do modelo com o método `evaluate`.","execution_count":null},{"metadata":{"trusted":true},"cell_type":"code","source":"model.evaluate(x_test, y_test_factor, verbose=0)","execution_count":null,"outputs":[]},{"metadata":{},"cell_type":"markdown","source":"Agora, com o histórico do treinamento que foi gerado, vamos criar uma visualização dos resultados.","execution_count":null},{"metadata":{"trusted":true},"cell_type":"code","source":"history = pd.DataFrame(history.history)","execution_count":null,"outputs":[]},{"metadata":{"trusted":true},"cell_type":"code","source":"history.plot()","execution_count":null,"outputs":[]},{"metadata":{"trusted":true},"cell_type":"code","source":"# Resultados da RNA Número de épocas 85\ny_pred = model.predict_classes(x_test)\nmodel_cm = confusion_matrix(le.transform(y_test.map(lambda x: x.strip())), y_pred)\nplot_cm(model_cm, \"dhos\")","execution_count":null,"outputs":[]},{"metadata":{"trusted":true},"cell_type":"code","source":"# Variação do número de épocas\nmodel = Sequential(name='Modelo2')\nmodel.add(Dense(4, input_dim=n_features, activation='relu'))\nmodel.add(Dense(10,activation='relu'))\nmodel.add(Dense(20, activation='relu'))\nmodel.add(Dense(n_classes, activation='softmax'))","execution_count":null,"outputs":[]},{"metadata":{"trusted":true},"cell_type":"code","source":"model.compile(loss='categorical_crossentropy', \n optimizer='adam', \n metrics=['accuracy'])","execution_count":null,"outputs":[]},{"metadata":{"trusted":true},"cell_type":"code","source":"model.summary()","execution_count":null,"outputs":[]},{"metadata":{"trusted":true},"cell_type":"code","source":"history = model.fit(x_train, y_train_factor,\n batch_size=5,\n epochs=48,\n verbose=1,\n validation_data=(x_test, y_test_factor),)","execution_count":null,"outputs":[]},{"metadata":{"trusted":true},"cell_type":"code","source":"model.evaluate(x_test, y_test_factor, verbose=0)","execution_count":null,"outputs":[]},{"metadata":{"trusted":true},"cell_type":"code","source":"history = pd.DataFrame(history.history)\nhistory.plot()","execution_count":null,"outputs":[]},{"metadata":{"trusted":true},"cell_type":"code","source":"# Resultados da RNA Número de épocas 48\ny_pred = model.predict_classes(x_test)\nmodel_cm = confusion_matrix(le.transform(y_test.map(lambda x: x.strip())), y_pred)\nplot_cm(model_cm, \"dhos\")","execution_count":null,"outputs":[]},{"metadata":{"trusted":true},"cell_type":"code","source":"# Variação do número de épocas\nmodel = Sequential(name='Modelo3')\nmodel.add(Dense(4, input_dim=n_features, activation='relu'))\nmodel.add(Dense(10,activation='relu'))\nmodel.add(Dense(20, activation='relu'))\nmodel.add(Dense(n_classes, activation='softmax'))","execution_count":null,"outputs":[]},{"metadata":{"trusted":true},"cell_type":"code","source":"model.compile(loss='categorical_crossentropy', \n optimizer='adam', \n metrics=['accuracy'])","execution_count":null,"outputs":[]},{"metadata":{"trusted":true},"cell_type":"code","source":"model.summary()","execution_count":null,"outputs":[]},{"metadata":{"trusted":true},"cell_type":"code","source":"history = model.fit(x_train, y_train_factor,\n batch_size=5,\n epochs=100,\n verbose=1,\n validation_data=(x_test, y_test_factor),)","execution_count":null,"outputs":[]},{"metadata":{"trusted":true},"cell_type":"code","source":"model.evaluate(x_test, y_test_factor, verbose=0)","execution_count":null,"outputs":[]},{"metadata":{"trusted":true},"cell_type":"code","source":"history = pd.DataFrame(history.history)\nhistory.plot()","execution_count":null,"outputs":[]},{"metadata":{"trusted":true},"cell_type":"code","source":"# Resultados da RNA Número de épocas 100\ny_pred = model.predict_classes(x_test)\nmodel_cm = confusion_matrix(le.transform(y_test.map(lambda x: x.strip())), y_pred)\nplot_cm(model_cm, \"dhos\")","execution_count":null,"outputs":[]},{"metadata":{"trusted":true},"cell_type":"code","source":"# Variação do número de camadas\nmodel = Sequential(name='Modelo4')\nmodel.add(Dense(4, input_dim=n_features, activation='relu'))\nmodel.add(Dense(10,activation='relu'))\nmodel.add(Dense(20, activation='relu'))\nmodel.add(Dense(40, activation='relu'))\nmodel.add(Dense(n_classes, activation='softmax'))","execution_count":null,"outputs":[]},{"metadata":{"trusted":true},"cell_type":"code","source":"model.compile(loss='categorical_crossentropy', \n optimizer='adam', \n metrics=['accuracy'])","execution_count":null,"outputs":[]},{"metadata":{"trusted":true},"cell_type":"code","source":"model.summary()","execution_count":null,"outputs":[]},{"metadata":{"trusted":true},"cell_type":"code","source":"history = model.fit(x_train, y_train_factor,\n batch_size=5,\n epochs=48,\n verbose=1,\n validation_data=(x_test, y_test_factor),)","execution_count":null,"outputs":[]},{"metadata":{"trusted":true},"cell_type":"code","source":"model.evaluate(x_test, y_test_factor, verbose=0)","execution_count":null,"outputs":[]},{"metadata":{"trusted":true},"cell_type":"code","source":"history = pd.DataFrame(history.history)\nhistory.plot()","execution_count":null,"outputs":[]},{"metadata":{"trusted":true},"cell_type":"code","source":"# Resultados da RNA Número camadas\n# 4 Camadas ocultas com função ReLU e Softmax\ny_pred = model.predict_classes(x_test)\nmodel_cm = confusion_matrix(le.transform(y_test.map(lambda x: x.strip())), y_pred)\nplot_cm(model_cm, \"dhos\")","execution_count":null,"outputs":[]},{"metadata":{"trusted":true},"cell_type":"code","source":"# Variação do número da camada final com função ReLU\nmodel = Sequential(name='Modelo5')\nmodel.add(Dense(4, input_dim=n_features, activation='relu'))\nmodel.add(Dense(10,activation='relu'))\nmodel.add(Dense(20, activation='relu'))\nmodel.add(Dense(n_classes, activation='relu'))","execution_count":null,"outputs":[]},{"metadata":{"trusted":true},"cell_type":"code","source":"model.compile(loss='categorical_crossentropy', \n optimizer='adam', \n metrics=['accuracy'])","execution_count":null,"outputs":[]},{"metadata":{"trusted":true},"cell_type":"code","source":"model.summary()","execution_count":null,"outputs":[]},{"metadata":{"trusted":true},"cell_type":"code","source":"history = model.fit(x_train, y_train_factor,\n batch_size=5,\n epochs=48,\n verbose=1,\n validation_data=(x_test, y_test_factor),)","execution_count":null,"outputs":[]},{"metadata":{"trusted":true},"cell_type":"code","source":"model.evaluate(x_test, y_test_factor, verbose=0)","execution_count":null,"outputs":[]},{"metadata":{"trusted":true},"cell_type":"code","source":"history = pd.DataFrame(history.history)\nhistory.plot()","execution_count":null,"outputs":[]},{"metadata":{"trusted":true},"cell_type":"code","source":"# Resultados da RNA Número camadas\n# 4 Camadas ocultas com função ReLU e Softmax\ny_pred = model.predict_classes(x_test)\nmodel_cm = confusion_matrix(le.transform(y_test.map(lambda x: x.strip())), y_pred)\nplot_cm(model_cm, \"dhos\")","execution_count":null,"outputs":[]}],"metadata":{"kernelspec":{"language":"python","display_name":"Python 3","name":"python3"},"language_info":{"pygments_lexer":"ipython3","nbconvert_exporter":"python","version":"3.6.4","file_extension":".py","codemirror_mode":{"name":"ipython","version":3},"name":"python","mimetype":"text/x-python"}},"nbformat":4,"nbformat_minor":4}
 \n